OpenAI: Jalapeño peittoaa NVIDIAn lippulaivan selvällä erolla

  • Keskustelun aloittaja Keskustelun aloittaja Kaotik
  • Aloitettu Aloitettu

Kaotik

Banhammer
Ylläpidon jäsen
Liittynyt
14.10.2016
Viestejä
25 791
OpenAI on esitellyt Hot Chips -tapahtumassa uuden Jalapeño-laskentapiirinsä suorituskykytestejä.

Yhtiön testien mukaan 700 watin TDP:llä varustettu Jalapeño voittaa NVIDIAn GB200:n 1200 ja GB300 1400 watin TDP:llä useissa kategorioissa. Sen käsittelykyvyn kerrotaan olevan testistä riippuen 1,7-3,6-kertaista per kulutettu kilowatti SemiAnalysis:n InferenceX-testikokonaisuudessa.

Matalan viiveen tapauksissa sen kerrotaan olevan jopa 8,6-104,3-kertaa niin nopea, kuin NVIDIAn GB300. Lisäksi yhtiö kehaisee, että se normalisoi testitulokset ilmoitetuille TDP-arvoille, vaikka sen Jalapeñon todellinen kulutus jäi 700 watin sijasta 550 wattiin ja alle.

Lähde: https://www.tomshardware.com/tech-i...s-nvidias-gb300-in-first-published-benchmarks
 
Lainaus: "... chip [Jalapeño] also doesn't train models, the workload where Nvidia's hardware remains unchallenged."

Miten Jalapeñon paremmuus pitäisi siis tulkita?
Se on päättelytehtäviin eli niiden mallien pyörittämiseen, ei opettamiseen.
 
Lainaus: "... chip [Jalapeño] also doesn't train models, the workload where Nvidia's hardware remains unchallenged."

Miten Jalapeñon paremmuus pitäisi siis tulkita?

1) Niitä ei saada tuotettua merkittäviä määriä (tarpeeksi halvalla)
2) Eivät kestä käyttöä
Todennäköisin vaihtoehto 3)
ovat hyviä jossain tietyssä kuormassa, mutta eivät yleisesti. Yksi piiri pydyy laskemaan kauhean nopeasti jotain, mutta sitten jumahtaa siihen kun pitäisi kommunikoida itsensä ulkopuolelle, ts. ei skaalaudu
 
Kannattaa huomata, että jalapenoa verrataan blackwell-piireihin. Nvidian Q3 liikevaihdosta 20% tulee vera-rubin:sta. vera-rubin rampup sangen vauhdikas ja blackwell myynti alkaa vähenemään kvartaali kvartaalilta. Ts. Nvidian lippulaiva alkaa näinä viikkoina olemaan vera-rubin eikä gb300.
 
Eikös ne muutkin nvidian kilpailijoiden kehittämät sirut ole voittaneet nvidian päättelyssä. Eivät silti ole ilmeisesti kokonaan nvidia korvanneet. Onko tämän kohdalla syytä odottaa erilaista lopputulosta?
 
Kannattaa huomata, että jalapenoa verrataan blackwell-piireihin. Nvidian Q3 liikevaihdosta 20% tulee vera-rubin:sta. vera-rubin rampup sangen vauhdikas ja blackwell myynti alkaa vähenemään kvartaali kvartaalilta. Ts. Nvidian lippulaiva alkaa näinä viikkoina olemaan vera-rubin eikä gb300.
Et kertonut, että mitä tämä vaikuttaa käytännössä, mutta näköjään Nvidian mukaan Vera-Rubin on jopa 10x tehokkaampi päättelyssä per watti kuin Blackwell.
 
Melkeinpä kaikissa lehdistötiedotteissa se esiteltävä viritys voittaa vertailtavan kilpailijan tuotteen - kun joku sopiva testi löydetään.
 
Et kertonut, että mitä tämä vaikuttaa käytännössä, mutta näköjään Nvidian mukaan Vera-Rubin on jopa 10x tehokkaampi päättelyssä per watti kuin Blackwell.
Riippuu niin paljon mallista ja parametreista millä ajetaan että vaikea antaa yhtä numeroa. Nvidian tekemä mittaus deepseek v4 1.6Biljoonaa parametria mallilla suorituskyky per MW kuvassa. jopa 30X enempi tokenia per MW versus gb300 nvl72
1787927750862.png
 
Lisäksi yhtiö kehaisee, että se normalisoi testitulokset ilmoitetuille TDP-arvoille, vaikka sen Jalapeñon todellinen kulutus jäi 700 watin sijasta 550 wattiin ja alle.
Eli todellisuudessa huonompi piiri ja ovat vain kertoneet tulokset jollain? Vai miten tuo voidaan "normalisoida" ylöspäin? Harvoin ne piirit ylöspäin skaalautuu perf/w kanssa.

E:
An appendix comparison using all-in utility power per accelerator, 1.18kW for Jalapeño against 2.55kW for the GB300, produces narrower gaps, as does pitting Jalapeño against a GB300 running multi-token prediction, where the peak efficiency lead shrinks to roughly 1.5 times.
 
Melkeinpä kaikissa lehdistötiedotteissa se esiteltävä viritys voittaa vertailtavan kilpailijan tuotteen - kun joku sopiva testi löydetään.
Näinpä juuri, mutta yhtä lailla jos voittavia mittareita löytyy sopivista paikoista tai riittävästi, se kertoo silti kilpailukyvystä. Ei niitä omaksi eduksi kääntyviä testejä ihan tyhjästä kuitenkaan tule, eikä tässäkään puhuta esim. pelkästä virrankulutuksesta (jolla ei yksinään liene paljoa tekemistä kilpailukyvyn kanssa).
 
Näinpä juuri, mutta yhtä lailla jos voittavia mittareita löytyy sopivista paikoista tai riittävästi, se kertoo silti kilpailukyvystä. Ei niitä omaksi eduksi kääntyviä testejä ihan tyhjästä kuitenkaan tule, eikä tässäkään puhuta esim. pelkästä virrankulutuksesta (jolla ei yksinään liene paljoa tekemistä kilpailukyvyn kanssa).
Ollaan niin energiaerajotteisia, että token/MW mittari on todella tärkeä.

Se on ihan selkeetä, että muutamaa/yhtä mallia varten optimoitu rauta on nopein sillä yhdellä mallilla. Geneerinen rauta voi ajaa mitä mallia tahansa. Molempia ratkaisuja tarvitaan + opetuskuormat päälle. Tän takia amazon, microsoft, meta, openai, google kaikilla on oma rauta työn alla/konesalissa ja siihen päälle geneeristä rautaa nvidia/amd:lta.

Äärimmäinen esimerkki kovakoodatusta raudasta on amd:n ostaman startupin ratkaisu missä piille on toteutettu mallin rakenne ja vain painoja voi muutella: AMD Acquires Taalas to Advance Compute Solutions for Rapidly Growing AI Inference Market

Lyhyellä aikavälillä, 1v-3v se joka saa eniten ostettua muistipiirejä saa eniten tehtyä kiihdyttimiä. Muistivalmistajat ovat tehneet jopa 3-5v diilejä. Vaikka olisi superhyper kiihdytin versus muut niitä ei välttämättä saa tehtyä merkittäviä määriä ellei ole jo tehnyt ennakkoon muistipiirien ostosopimuksia. Toisaalta taas 2v, 4v, 6v päästä pitää olla uudet kiihdyttimet kun kiihdytinpuolella piirien arkkitehtuuri vaihtuu 2v välein ja välivuosina tulee räkkitason+paketointitason päivityksiä.
 
Ollaan niin energiaerajotteisia, että token/MW mittari on todella tärkeä.
Tarkoitin absoluuttista virrankulutusta, en sitä, mitä sillä suorituskyvyn kannalta saa. Siitä olemme varmasti samaa mieltä, että suorituskykyyn suhteutettu virrankulutus on varmasti hyvinkin kiinnostava mittari.
 
Tarkoitin absoluuttista virrankulutusta, en sitä, mitä sillä suorituskyvyn kannalta saa. Siitä olemme varmasti samaa mieltä, että suorituskykyyn suhteutettu virrankulutus on varmasti hyvinkin kiinnostava mittari.
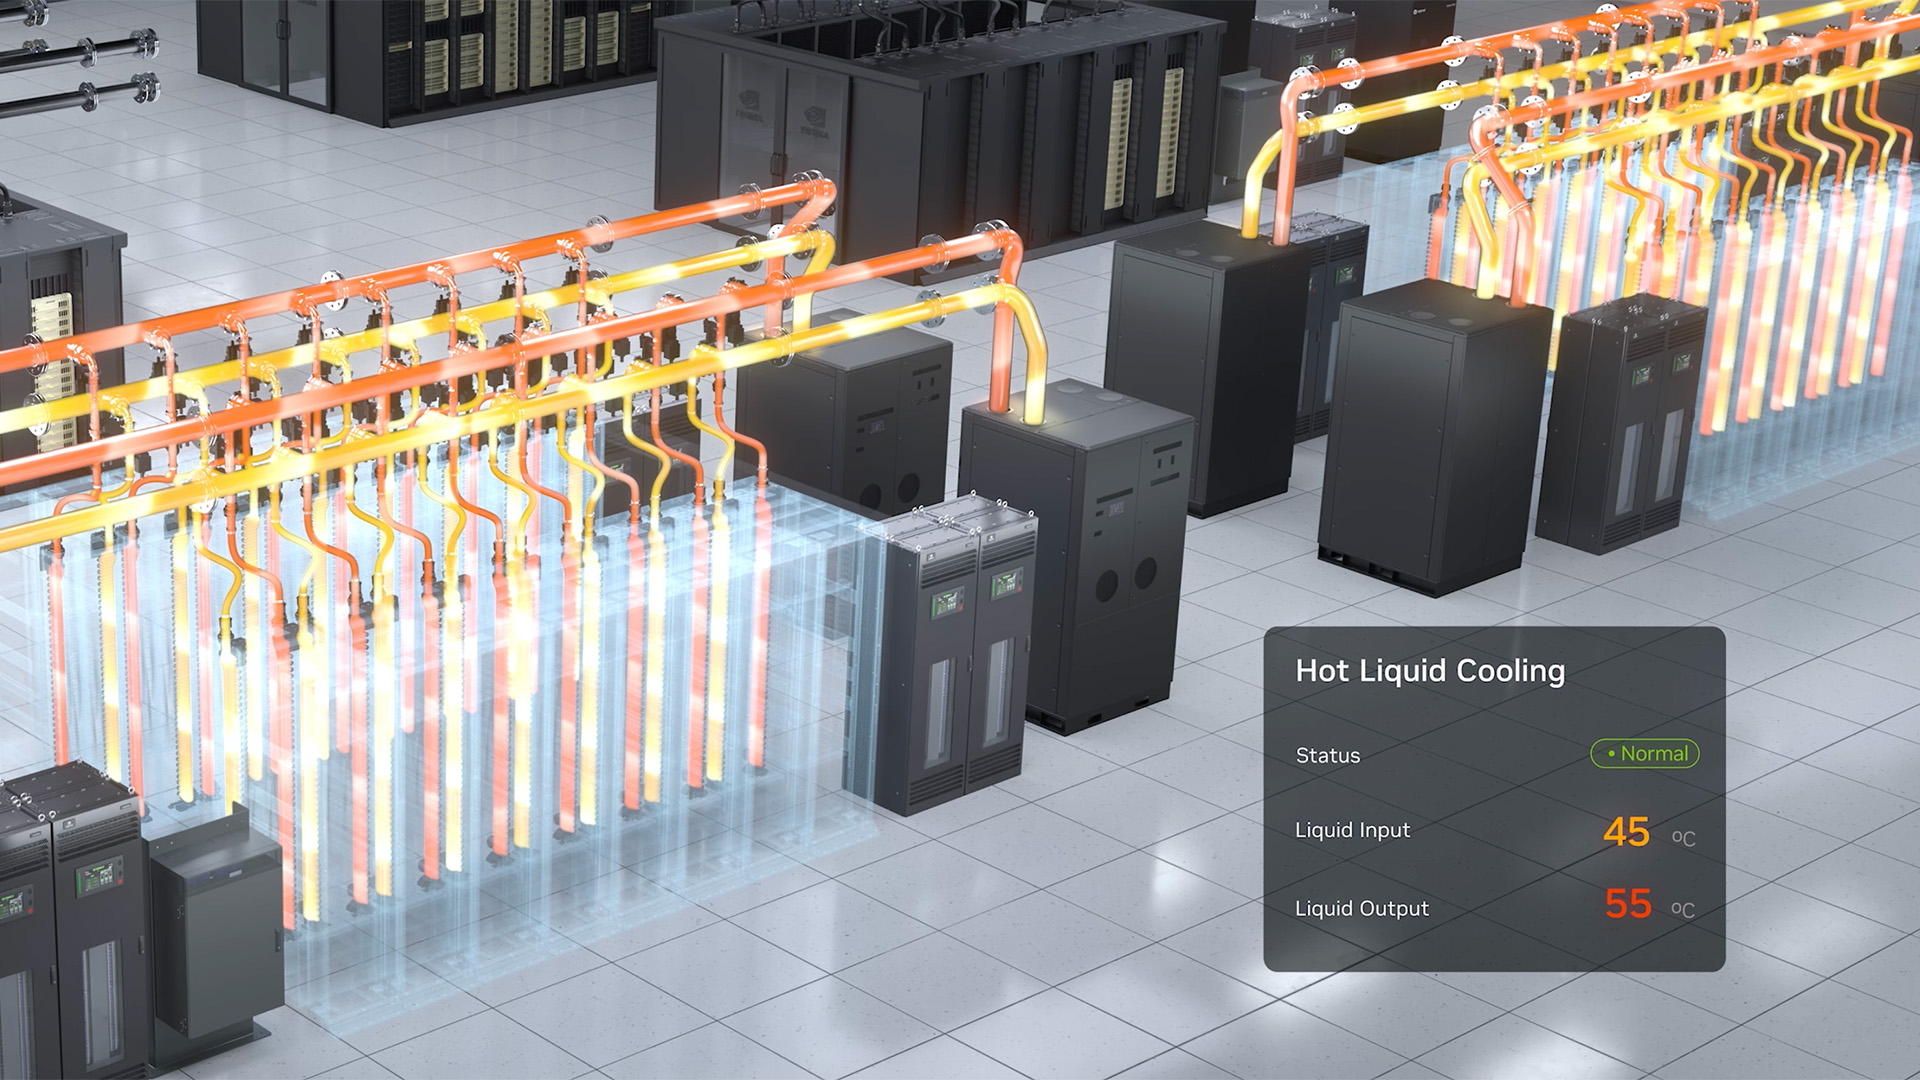
Jos nyt sivusta jatkan tähän niin token/MW vaikuttaa todella paljon räkkitason toimintakyky+verkkopuoli ja miten jäähdytys ja virransyöttö tehty. Frontier mallit/kyvykkäämmät mallit eivät mahdu yhdelle kiihdyttimelle. Paras mittari on mitä saat per MW ulos konesalista kun katsotaan kaikkien osien virrankulutusta. Jos katsoo vain pelkkää kiihdytinpiiriä voi vetää täysin vääriä johtopäätöksiä. Esim. nvidialla on vera-rubin:ssa mahdollisuus käyttää jopa 45C nestettä piirien viilennykseen mikä säästää valtavasti energiaa versus pitäisi jäähdyttää nestettä enemmän. Toinen puoli mikä nvidialla(ja muilla myös) tulossa 800V DC ratkaisu mikä yksinkertaistaa ja parantaa virransyöttöä.

 
Viimeksi muokattu:
Jos nyt sivusta jatkan tähän niin token/MW vaikuttaa todella paljon räkkitason toimintakyky+verkkopuoli ja miten jäähdytys ja virransyöttö tehty. Frontier mallit/kyvykkäämmät mallit eivät mahdu yhdelle kiihdyttimelle. Paras mittari on mitä saat per MW ulos konesalista kun katsotaan kaikkien osien virrankulutusta. Jos katsoo vain pelkkää kiihdytinpiiriä voi vetää täysin vääriä johtopäätöksiä. Esim. nvidialla on vera-rubin:ssa mahdollisuus käyttää jopa 45C nestettä piirien viilennykseen mikä säästää valtavasti energiaa versus pitäisi jäähdyttää nestettä enemmän. Toinen puoli mikä nvidialla(ja muilla myös) tulossa 800V DC ratkaisu mikä yksinkertaistaa ja parantaa virransyöttöä.

Kiitos tiedosta.
 

Statistiikka

Viestiketjuista
314 703
Viestejä
5 340 517
Jäsenet
84 877
Uusin jäsen
KPaul

Hinta.fi

Back
Ylös Bottom