AI-koodausavustimet, keskustelua AI-avustetusta koodaamisesta/skriptaamisesta/dokumentoinnista/...

Ei varmasti mene ketjun aiheeseen liittyvät koodaustaskit mene yhdellä 23B MoE:lla. Taski realistisesti käyttää niin isoa osaa mallista ettei esim. 24GB kortilla mihin tuo yksi MoE mahtuu pääse mihinkään.

Toisella tapaa sanoen, jos koodaukseen riittäisi yksi 23B MoE niin miksi shipata sitä 501B mallin sisällä...

Tuon mallin pointti on, että kun siinä ajetaan koodaustaskeja niin kuorma jakaantuu supertasaisesti eri MoE:n kesken. Jos MoEt on jaettu useille kiihdyttimille niin kiihdyttimien kuorma on tasainen sen sijaan että yksi kiihdytin idlaisi ja toiselle olisi enemmän laskentaa tarjolla kuin mitä kortti kykenee laskemaan.
En ole väittänyt että se olisi yksi 23B ekspertti. Päinvastoin, kerroin että yleensä niissä aktivoidaan useita eksperttejä per token. Reflection ei ole vielä avannut tarkkaa eksperttien määrää, mutta aktiivisten parametrien määrän on kerrottu olevan tuo 23B.

Ja juuri siksi se on 501B malli, että siellä joka tokenille voidaan valita eri ekspertit. Laskenta silti tehdään aina vain 23B yli, vaikka koko malli onkin 501B. Eli kun teet ketjun mukaista ohjelmointitaskia, siellä voidaan yhdessä taskissa käyttää ihan kaikkia noita eksperttejä, ihan 501B parametrin edestä. Mutta yksittäiselle tokenille silti lasketaan ne vain 23B parametrin yli.

Ainoa asia mikä sun MoE-ymmärryksessä menee nyt oikein, on tuo että laskenta (ja myös muistiväylän käyttö) jakautuu tasaisesti eri laskentayksiköille, mikä on erittäin toivottavaa.

Ehkä nyt ymmärrän jotain väärin alkuperäisessä pointissasi tai jotain?
 
Viimeksi muokattu:
Experttien käyttöasteesta beam:in kanss
Niin, eli yleisimmin käytetty ekspertti on 1,04x kertaa yleisemmin käytössä kuin muut? Silti siellä joka laskenta joka tokenia varten käyttää vain 23B parametria. Eli esim. ekalle tokenille käytössä ekspertit A, B ja C, sitten seuraavalle B, G ja P, kolmannelle A, H, ja I. Ja kun tätä sitten toistetaan loputtomiin, on se suosituin ekspertti ollut mukana 1,04x useammille tokeneille, kuin muut keskimäärin.

Se ei silti tarkoita että koko malli olisi aktiivisena missään vaiheessa, vaan siellä on aina se alijoukko eksperteistä aktiivisena. Yhteensä 23B parametrin verran.
 
AI + Blender on niin hyvä yhdistelmä ettei kannata mitään 2D grafiikkaa enää vääntää.
Ajattelin kokeilla vaihtaa tuohon kaikki animaatioita vaativat osat 3D ja shaderi päälle, joka muuttaa pikselitaiteeksi, saa nähdä miten toimii.

Seurannut tuota /r/aigamedev subreddittiä jonkin aikaa ja suurin osa on roskaa.
Suosituksissa oli tämä, joku kopioinut CS2 Astralla nettiversioksi:
Valve näköjään pistänyt äkkiä alas. Mutta melko vaikuttavaa miten helposti kloonaavat softaa.
 
Taidan minäkin viimein saada töissä GitHub Copilot lisenssin Java framework hommiin. Toisaalta siinä vielä noin kahdentoista ihmisen hyväksyntää vaille(!) niin en henkeä pidättele sen suhteen. ;)
Saanko arvata että siellä +60 vuotiaat IT osastolla nihkeänä vaikeroi ja unelmoi 90-luvun palvelin elämästä? Illalla tuudittavat itsensä uneen hokemalla tietoturvasta.
 
Viimeksi muokattu:
Metan uusi malli Muse Wonder julkaistu ja ainakin benchmarkkien perusteella saanut nyt käytännössä Anthropicin ja OpenAI:n kiinni. Varmasti benchmaxattu toki, mutta niinhän ne on muillakin...


1791827088744.png
 
Google Meta on hinnoitellut Wonderin samalle tasolle kuin Opus 5.5.
1791838289665.png

Edit: Fixattu Meta eikä Google
 
Viimeksi muokattu:
Well, my first impression is that it's still a step below Astra/Opus5.5/Fable here. Intelligence is there I think, but 'taste' and 'judgment' is not there yet. Personality seems okay but that doesn't help when it got stuck into a loop by being fixated on the review comments (on iteration 7 of review->fix last I checked) without taking a step back and reconsidering, and this is on a relatively simple change.

Limits seems okay-ish on the $50 plan but not too generous I think.
mage->HTML test for Muse Wonder. It's much worse than Opus 5.5. IMO it's closer to Sonnet or Haiku for this test.
Muse Wonder (high): LCARS Starships — Explore Without Limits

Opus 5.5 (high): LCARS Starships — Explore Without Limits

Original design: https://diffui.ai/app/canvas/5093e689-1e74-4f26-b632-2a4500f...

I was expecting much more given the benchmark numbers it was putting out. I suspect its vision model isn't mature yet, and that it's been heavily optimized for text at this point in time.
I wish I could benchmark Muse Wonder Full, because Muse Wonder isn't much better than Muse Spark 1.3[1]. I created a brand new programming language designed to confuse LLMs[2] and created a model benchmark out of it.
A lot of the tasks were failed because they exceeded the $5 budget though, so maybe it would have gone on to complete them, it just required a lot of funds to do so. Still, that's the benchmark, and it's not better than MiMo V2.6 Pro which is pretty disappointing.

1 - KillSwitch-Bench

2 - KillSwitch
 
Google Meta on hinnoitellut Wonderin samalle tasolle kuin Opus 5.5.
Mikähän tuossa on idea? Luulisi, että keräisivät käyttäjiä halvalla hinnoittelulla, mutta ei kai tuommoisia ala kukaan maksamaan tuosta. Toivottavasti tuostakin tulee vielä joku 97% alennettu contributor, Spark 1.3 tykkään sen verran, että kelpaisi.
 
Purkavatkohan openai/anthropic/... binaareita opetusmateriaaliksi? Tämä vois selittää miksi esim. retrokoneille koodintekokyky noussut. Aika harmaa alue tietenkin reverse engineerata opetusmateriaaliksi, mutta ihan mahdollinen keissi? Tän jos vie äärimmäisyyteen niin voisivat tehdä saman kaupallisillekin softille,... Parempi vaan olla jäämättä kiinni sellaisesta jos tuolle tielle lähteneet. Toki voi koko homman ulkoistaa ja kädet pystyyn "me ostettiin vain opetusdataa, ei tiedetty miten opetusdata on luotu". RL vaiheeseenhan on hyvin tyypillistä ostaa asiantuntijoiden tekemiä tehtävä+vastauspaketteja mitä käytetään.

Melkoinen läjä lisää opetusmateriaalia koodausmalleille jos reverse engineeratut binaaritkin käytössä.
 
Purkavatkohan openai/anthropic/... binaareita opetusmateriaaliksi? Tämä vois selittää miksi esim. retrokoneille koodintekokyky noussut. Aika harmaa alue tietenkin reverse engineerata opetusmateriaaliksi, mutta ihan mahdollinen keissi? Tän jos vie äärimmäisyyteen niin voisivat tehdä saman kaupallisillekin softille,... Parempi vaan olla jäämättä kiinni sellaisesta jos tuolle tielle lähteneet. Toki voi koko homman ulkoistaa ja kädet pystyyn "me ostettiin vain opetusdataa, ei tiedetty miten opetusdata on luotu". RL vaiheeseenhan on hyvin tyypillistä ostaa asiantuntijoiden tekemiä tehtävä+vastauspaketteja mitä käytetään.

Melkoinen läjä lisää opetusmateriaalia koodausmalleille jos reverse engineeratut binaaritkin käytössä.
Mahdollista, ei se periaatteessa ole laitonta. Mutta todennäköisesti ainakaan OpenAI ei ole aiemmin kouluttanut GPT:tä retromateriaalilla, ei varsinkaan käyttäen HW manuaaleja. Vähän sellainen tunne tuli kun tein Amiga-emulaattoria GPT 5.5/5.6:lla, vasta Astra alkoi ymmärtämään laajempaa kokonaisuutta.

Anthropic lienee alunperin enemmän keskittynyt kaikenlaiseen koodausmateriaaliin. Ehkä sen takia Claude on niin hyvä koodauksessa, GPT taas ratkoo millenium ongelmia.
 
Mahdollista, ei se periaatteessa ole laitonta. Mutta todennäköisesti ainakaan OpenAI ei ole aiemmin kouluttanut GPT:tä retromateriaalilla, ei varsinkaan käyttäen HW manuaaleja. Vähän sellainen tunne tuli kun tein Amiga-emulaattoria GPT 5.5/5.6:lla, vasta Astra alkoi ymmärtämään laajempaa kokonaisuutta.

Anthropic lienee alunperin enemmän keskittynyt kaikenlaiseen koodausmateriaaliin. Ehkä sen takia Claude on niin hyvä koodauksessa, GPT taas ratkoo millenium ongelmia.
Eiköhän winuae/fs-uae yms. koodit ole ollut pitkään malliennopetusmateriaalissa kun ovat open sourcea. Githubissa myös iso kasa amiga asm ja c projekteja mitkä lienevät myös sisällä opetusmateriaaleissa.
 
Eiköhän winuae/fs-uae yms. koodit ole ollut pitkään malliennopetusmateriaalissa kun ovat open sourcea. Githubissa myös iso kasa amiga asm ja c projekteja mitkä lienevät myös sisällä opetusmateriaaleissa.
Pelkkä lähdekoodi ei riitä. Vanha GPT ei selvästi ymmärtänyt Amigan HW rekistereistä laajemmin. HRM sanoo että minimi AUDxPER rekisteriin on 124. Mutta miksi? Mitä jos siihen laittaa 17? GPT ei osannut ymmärtää laajemmin miten se toimii. Se vain luki paperista että 124 on minimi.

Lisäksi jos haluaa oikeasti optimoida, niin täytyy tuntea 68k:n sisäinen toiminta. CLR on väärä valinta 68000:lla, prefetch tai icache vaikuttaa koodin optimointiin. Näissä GPT 5.6:lla on selkeitä mustia aukkoja. Gemini oli viisaampi, mikä oli yllättävää.
 
Purkavatkohan openai/anthropic/... binaareita opetusmateriaaliksi?
Pienemmältä pahalta tuo kuulostaa kuin se määrä piratismia mistä kärähtivät jo.

Purin juuri huvikseen koneideni BIOSit, eipä käynyt mielessäkään, että tämmöinen olisi piilotettuna, nyt joutuu läppäriäkin kellottelemaan. :smoke: Kaikissa myös "malwarea", kun tyrkyttävät Windowsin Updatelle softiaan. Ei sentään sen pahempia asioita löytynyt.
1791882767395.png
 
Pelkkä lähdekoodi ei riitä. Vanha GPT ei selvästi ymmärtänyt Amigan HW rekistereistä laajemmin. HRM sanoo että minimi AUDxPER rekisteriin on 124. Mutta miksi? Mitä jos siihen laittaa 17? GPT ei osannut ymmärtää laajemmin miten se toimii. Se vain luki paperista että 124 on minimi.

Lisäksi jos haluaa oikeasti optimoida, niin täytyy tuntea 68k:n sisäinen toiminta. CLR on väärä valinta 68000:lla, prefetch tai icache vaikuttaa koodin optimointiin. Näissä GPT 5.6:lla on selkeitä mustia aukkoja. Gemini oli viisaampi, mikä oli yllättävää.
Mä uskon, että kyvykkyys on yleisesti malleissa parantunut. Ei syynä kourallinen käyttäjiä ja niiden datat amigaprojekteista. Ylipäänsä mallit mille tahansa alustalle kirjottavat paremmin rautaläheistä koodia, yleisesti ottaen parempi kyvykkyys malleissa ja harnessissa ja mcp servereissä reverse engineeraukseen, tajuavat manuaalit paremmin jne.

--

Kirjoitutin ai:lla keväällä ihan järjettömän määrän motorolan 68000 ja 68060 benchmarkkeja micro ja macro tasolla. Näitä hiottiin oikeat koneet loopissa, että saatiin ohjeet AI:lle miten optimoida koodit. 060:lle samalla selviteltiin miten eri käskyjä voi tai ei voi ajaa rinnakkain + prefetch säätöä cachelinjojen lataukseen. Voisin laittaa toki egoa peliin ja "tän takia ai on nyt etevä" amiga assyssa. En usko, että tällä oli mitään tekemistä kielimallien parantumisen kanssa.

Yksi iso syy parantuneeseen lowlevel koodauskykyyn lienee mallivalmistajien tarve optimoida omat kernelinsa cudalle ja omille kiihdyttimilleen. Satsattu RL vaiheessa siihen, että mallit oppivat tekemään tehokasta koodia. Säteilee sitten muuallekin. Tuokin vain yksi pieni palanen kokonaisuudesta eikä ainoa syy.
 
Viimeksi muokattu:
Tuli ihan mielenkiinnosta kokeiltua kuinka OpenCoden avulla onnistuu pienen appin teko käytännössä ilman minkäänlaista kokemusta koodaamisesta.
Lopputuloksena oli n. 4 tunnin jälkeen ihan kohtuu toimiva Pythonilla tehty GUI ohjelma jolla pystyy automaattisesti säätämään Pipewiren näytteenottotaajuutta ja bittisyyttä lähdemateriaalin mukaan ja joka myös näyttää äänenulostulo laitteen tukemat näytteenottotaajuudet ja bittisyydet.

Alunperin ajattelin ympätä myös autoEQn mukaan, mutta Easyeffect hoitaa jo kyseisen homman Linuxilla, niin jätin sen lopulta pois.

Pipewire audio GUI

Todennäköisesti dokumentaatio on puuttellinen ja sisältää tarpeettomiakin osioita joita siellä ei tarvitsisi, mutta minkäs teet, kun ei ole aikaisempaa kokemusta koodaamisesta saati dokumentoinnista.
Lisäksi kyseessä oli lähinnä tarkoitus testata onnistuuko tuommoisen teko, kun olen tuon tyyppistä appia kaivannut jo vuosia ja nyt sain sit aikaiseksi kokeilla saisiko AI tehtyä sen.

Projekti on nyt edennyt versioon 1.4.

Kaikki halumani ominaisuudet ovat pitkälti mukana ja olenkin nyt keskittynyt lähinnä bugien ja virheiden metsästämiseen ja käytännön testaamiseen.

Vaikka ohjelma onkin alkujaan pääasiassa tehty omaan käyttööni, niin olisi mukava saada muilta käyttäjiltä kommentteja, mielipiteitä ja palautetta ohjelmasta.
 
Yllätys oli kova kun tänään kilahti sähköpostiin Enterprice GitHub "welcome" :)
Malleja jopa ihan hyviäkin meille tarjolla mm Sonnet 5.5, GPT-6-sol, GPT-6.1-sol tuossa parhaimmat. Yllätyin, että Kimi K3 listoilla myös, noin Kiinalaisena.

On se nyt nähty, että isotkin laivat kääntyy.
 
Torvalds alkanut koodailemaan clauden avulla linux kerneliä. Optimoi pienien tiedostopalasten käsittelyä AI:n avulla + jotain mystisen kompleksista assoc_array kirjaston kanssa.
"The code, the test programs, the review behind the list above and the first draft of this text were done with an LLM coding assistant (Claude Code) under my direction. The measurements were run on my machine." Linus Torvalds Working On A Hefty Linux Kernel Improvement With Claude Code - Phoronix
1791953420304.png

"Nils Ollrogge reported a bug in the assoc_array library and had a patch to fix it too, but that code was too obscure for me to follow, so I did what I preach: use modern LLM tools to help make sense of it all.

So this is an LLM-assisted branch which makes the code more readable by splitting up some of the larger and hard-to-read functions. The code was then run through a test harness in user space, which not only confirmed the bug Nils reported, but found three other bugs too - all going back to the very first commit adding this library back in 2013."
Toisissa uutisissa huhutaan fable5.5 julkistusta tälle viikolle. OpenAI:lta huhutaan astra5.1:sta tulevaksi kuukauden sisään.
 
Anthropic:lla tipahti git:sta suorituskykyrenkaat kuorman alla. Mielenkiintoinen pitkä ja kattava blogipostaus aiheesta ja miten kehittävät omia uusia järjestelmiä. Lainauksissa hyvin pieni osa, kannattaa lukea kokonaan. He eivät ole rakentaneet git:in korviketta vaan aika erilaisen järjestelmän joka skaalautuu järjettömänison kuorman alla.

Kuormasta
May 2026, Anthropic averaged around 2,500 code changes merged per day; as of September, we merged over 30,000 per day.
We perform on the order of 25 million code checkouts per day for CI, before counting developer environments, agent sandboxes, and research jobs. Fetched naively, that would be over 600 PB of git traffic per day.
Mikä on ihmisen rooli
Engineers are no less valuable, but their work is changing. All of the engineers who worked on this system would now rate Claude as better at writing code than them. But our engineers still supplied the invaluable understanding of the high-level inter-system components and the design-level tradeoffs, making informed choices around the problems we wanted to solve and the scale we knew we needed to achieve. Very often, we found that the role of the engineers was to tell Claude “no.”
Our team members still review every change request for the system, but they now examine the intent of the change as opposed to reading every line of code.
Jätin heidän uusien järjestelmien kuvauksen pois postauksesta. Blogista löytyy kattavasti. Ajattelin, että kuorma ja ihmisen asema softakehityksessä olisi tämän ketjun kannalta antoisin asia lainata. Joskus CI järjestelmiä ja mono repoa tunkanneena tunnistan jo pienemmän kuorman altakin tuttuja kipupisteitä.

Scion is by no means a suitable replacement for git for general use. The concepts we’ve outlined here really only make sense for truly enormous monorepos, with either tens of thousands of engineers or swarms of agents prolifically writing code. Plus, Anthropic is unique in that our ability to spend tokens for internal use far exceeds what any other business would realistically want to spend. We do this both to address our own software development needs, and to test Claude’s capabilities
 
Minä kun tuonne EAB foorumille oon puskenut noita in-game modeja, niin minusta sitten kirjoiteltu netissä että "Legend coder Timo.." jne.
Tuossa viimeisimpään ketjuun avasin asiaa miten ne on tehty, custom sandboxissa missä [Amiberry MCP(omatekoinen) <-> AI Agent <-> Ghidra MCP] agentilla tyyliin täydet testausmahdolisuudet jne. Voin vaan veikata miten seuraavaksi olen vibekoodari ;)

Noin ei vanhat Linux parratkaan helpolla tule hyväksymään, että AI:lla voi koodia oikeasti luoda.
 
Hieman testailin tuota Enterprice GitHub Copilottia tänään, siinä tiukempi kuukausiraja kuin mitä on Claude $20 viikkoraja :lol:
Noi personal tilit on vielä aika paljon subventoitu. Todennäköisesti loppuu IPOjen jälkeen. Firmojen tilit menee ihan API hinnoilla, teillä valittiin aika alhainen budu :)
 
Noni, firma on sitte valinnu hienon lähestymistavan: "Meillä on hieno AI-strategia ja se ei maksa juuri mitään (eikä sillä myös saada aikaan juuri mitään)".
Tätä on oikeasti "hauska" katsella, kun hyödyt tunnistetaan jo, mutta rajat vedetään aivan jäätävän tiukalle ja ihmetellään, kun tuloksia ei synny. Sit en näkis, että pelkkä tehostaminen on se oikea suunta. Eli nyt teillä on nämä, niin vähennetään firmasta se 30% devaajia pois. Vaan pitäis ehkä katsoa, mitä kaikkea ei ole tehty, kun budussa ei ole ollut 200-300k tilaa softalle. Nyt näitä tekee sisäisesti aika halvalla.
 
Google kyllä hyvä firma, subini ei tarjoa Argonia, mutta näköjään löytyy jo muiden firmojen halpasubeista:
1791993228146.png
 
Muse Wonderia kehuttu paikoin kovasti, laitoin 50€ tilauksen väliaikaiseen testiin, että miten reverse engineeraus sujuu.
 
Ai että kyllä kelpaa ajella Clauden Mythoksella! Ei paljoa valittele, ei pysähdy, ei defaulttaa Opus 4.8 RE-hommissa ja tekee työtä käskettyä. Puksuttaa kuin juna eteenpäin. Parasta on että saa todella jotain aikaiseksikin ja melkoisen reipasta vauhtia.

Kulutus on samaa kuin Fablella, eli ei tunnu juuri missään Maxilla. Toki jos haluaa spawnata 5+ agenttia touhuamaan niin sittenhän se jo alkaa näkymäänkin.

1791999929825.png
 
Anthropic:lla tipahti git:sta suorituskykyrenkaat kuorman alla. Mielenkiintoinen pitkä ja kattava blogipostaus aiheesta ja miten kehittävät omia uusia järjestelmiä. Lainauksissa hyvin pieni osa, kannattaa lukea kokonaan. He eivät ole rakentaneet git:in korviketta vaan aika erilaisen järjestelmän joka skaalautuu järjettömänison kuorman alla.
Oli jo aikakin. Git alkaa olla vanhentunut online aikakaudella.

Mutta tosiaan. Koodin määrä moninkertaistuu, muutosten määrä moninkertaistuu ja niitä tulee tiheämmin. Perinteiset ohjelmistonkehitysmenetelmät eivät enää toimi. Perinteinen pull request -> review -> merge putki ei enää toimi. Buildiserveri huutaa hoosiannaa.

Ja sitten vielä: onko enää järkevää devata koodia omalla läppärillä? Pilveen koodausympäristö.
 
Muse Wonderia kehuttu paikoin kovasti, laitoin 50€ tilauksen väliaikaiseen testiin, että miten reverse engineeraus sujuu.
Illalla jätin Muse Coden tekemään Amiga pelistä tutkimusta, sitä hetken katselin niin nopeaa tekemistä, tuli lähinnä Deepseek mieleen (että hutiloiden tehdään).
edit: tässä Muselle sillain löysää annettava, että toimi ilman emulaattoria missä se olisi voinut vahvistaa Ghidra havaintoja.
Koodi:
Tarkkuus: 7½

Tarkistin, ja nämä pitävät:

Purkaja tuottaa täsmälleen saman 86 tiedoston inventaarion kuin dokumentissa.
Kaikki 10 testiä menevät läpi ja RNC-pakattujen tiedostojen tarkistussummat täsmäävät.
Kaikkien 16 kentän round trip on tavutarkka.
Kaikki .cas-tilastot toistuivat täsmälleen: 114059 tiiltä, 2532 eri arvoa, attribuuttijakauma ja tietueiden maksimimäärät.
Koodin puolella oikein:
bootblockin vakiot
LoadDiskDirectory (sektori 22, 4 sektoria)
andi #$1FF täsmälleen 11 kohdassa
FindStepDirectionin attribuuttitaulukko vastaa koodia rivilleen
“Ei kirjoituspolkua” pitää: ainoa levyn DMA-käynnistys on lukukäsky $8000|len osoitteessa $C05802.

Virheet ja aukot:

Attribuutit ja tietuetyypit on kytketty väärin, vaikka osio on merkitty “confirmed”. Moottori kirjoittaa poimintatietueen (S5) luokkasanan suoraan karttaan ($C1A26E-$C1A282). Oikeat arvot ovat S2 = 3, S4 = 5 ja S5 = 6. Dokumentissa ne ovat 6, 2 ja 4, eli arvot on siirretty yhdellä bitillä.
Väite “jokaisella exit-padin tiilellä on S4-tietue” on väärä. 219 tiilestä vain 81:llä on, eli suunnilleen yksi tietue klusteria kohden.
Poimintagrafiikoita on 380-419 (40 kpl), ei 380-418 (39 kpl).
S4 eivät ole “sijoitettuja vihollisia”, vaan 3x3-templaten avulla sijoitettuja objekteja. Kentässä +$1D on templaten indeksi, +8..+$19 tallentaa templaten alle jäävät tiilet ja negatiivinen +$1A viittaa kohdekenttään. Malli merkitsi tämän hypoteesiksi, mutta editorin datamalli on rakennettu sen päälle.
Lukeminen jäi pinnalliseksi. SetupLevel oli nimetty ja luettu, mutta sen suoraan näyttämiä asioita jäi “avoimiksi”:
tilesetin kokoaminen: setit 4-5 ovat lev4bak (240 tiiltä) + lev5/6bak (140 tiiltä) = 380
poimintagrafiikoiden lataus: $1400 tavua, eli juuri 40 tiiltä
kentän objektilista, jonka tyypin 7 objektit lasketaan osoitteeseen A5+$CC0. Se on todennäköisesti nodejen määrä, jota dokumentit listaavat ratkaisemattomana.

SetupLevel kutsuu suoraan funktiota $C1A226, josta S4:n merkitys olisi selvinnyt, mutta sitä ei avattu.

Levyillä on dokumentoimattomia alueita. Levyn 1 sektoreilla 2-10 on DOS-latauskoodin jäänne (“dos.library”, “df0:achaos”). Levyn 2 sektorit 2-10 ja 1738-1759 ovat kokonaan selittämättä.

Tavutasolla työ on 9:n tasoa, koodin merkityksen tulkinnassa noin 6:n.

Dokumentointi: 7½

Hyvää:

Rakenne on selkeä, ja lähes jokaisen väitteen tukena on osoite tai muu todiste.
Confirmed- ja hypothesis-merkinnät ovat enimmäkseen kurinalaisia.
Journal on ajan tasalla.
Amiberryn sandbox-ongelma on raportoitu rehellisesti.

Heikkoa:

Korjaukset eivät leviä dokumentista toiseen. Viimeinen commit korjasi LoadLevelData-tulkinnan kahteen tiedostoon, mutta integration.md:45 kuvaa yhä vanhan, väärän tulkinnan.
data-model.md:32 sanoo tiiliformaatin “split undecoded”, vaikka samassa tiedostossa sama asia on “resolved”.
ramer on ratkaistu, mutta kaksi dokumenttia kutsuu sitä yhä tuntemattomaksi.
“Confirmed”-leimaa on käytetty myös johdetuille tulkinnoille, ks. tarkkuuden kohdat 1 ja 2.
docs/functions/ ja docs/decisions/ ovat tyhjiä.
Ghidra on käytännössä annotoimatta: 592 funktiosta 19 on nimetty, kommentteja on yksi, eikä rakenteita ole lainkaan. Tieto on vain markdownissa.
Käytettävyys: 8
Tuottavuus on kova. Noin tunnin commit-ikkunassa syntyivät levyn purkaja, kaksi RNC-purkajaa, .cas-koodekki, testit, emulaattoriskenaario ja 13 dokumenttia.
Projektin säännöt pitivät: original/ on koskematon (SHA-256 täsmää), gitissä ei ole pelidataa, commitit ovat pieniä ja hyvin nimettyjä ja Ghidra-ohjelmat oli suljettu.
Malli korjaa itseään eikä keksi havaintoja.
Tyypillinen heikkous: malli nojaa datan tilastolliseen muotoon ja ulkoiseen liidiin (Chaos Construct) eikä seuraa ristiviittauksia koodissa loppuun asti. Työ kaipaa siksi toisen tarkistajan ennen kuin editorin spesifikaatioon voi luottaa.
Nyt pyysin Opus 5.5 tekemään arvion sen tekemisistä kouluarvosanoin
1792035260150.png

EDIT2: laitoin hiekkalaatikko moden pois niin emulaattorin käyttö onnistui ilman jatkuvia hyväksyntöjä, pyysin tarkastamaan työntä ghidran ja amiberryn kanssa.
Koodi:
Mitä se korjasi tai löysi (tarkistin, pitää paikkansa)
$C132D2 on viimeksi ladatun tiedoston koko, ja $3DC00 on title.mod:n koko. Testi tarkistaa nyt tarkan arvon.
class $900 -arkistot: sngarc.bin sisältää 29 alatiedostoa. Niistä 7-22 ovat kenttäkohtaisia 20-tavuisia listoja ja 23-26 ovat 40 tiilen poimintagrafiikoita. Tarkistin rakenteen tiedostosta itse. Tämä on hyvä uusi löydös.
Bootblockin vähämuistihaara: jos muistia on alle $AF000, bootblock lataa ramerin offsetista $3400. Vahvistin tämän bootblockin tavuista. Muse kokeili myös 512 KiB:n profiililla emulaattorissa.
DetectDrives: “toinen rekisteriryhmä” osoittautui koodiksi. Muse määritteli funktiot Ghidrassa ja nimesi ne.
Levynvaihtopolku on nyt dokumentoitu koodista.
SetupLevelin tiedot ovat nyt dokumenteissa: tilesetin kokoaminen, kaikki 7 osioiden osoitinta ja A5+$A16.
Vanhentuneet tekstit korjattu: integration.md, data-model.md:n “split undecoded” sekä ramer kahdessa dokumentissa.
Auditointiraportti on erinomainen: siinä on menetelmä, kattavuuden rajat ja todisteketju.
Mitä jäi korjaamatta
Attribuuttien bittisiirtovirhe on yhä cas.md:n confirmed-taulukossa (rivit 46, 48 ja 50).
Väite, että jokaisella exit-padin tiilellä on S4-tietue, on yhä paikallaan. Oikeasti näin on vain 81 tiilellä 219:stä.
Poimintagrafiikoiden määrä on nyt ristiriidassa saman kappaleen sisällä. cas.md sanoo “380-418 (39 graphics)” ja heti perään “380 to 419”. data-model.md sanoo edelleen 39.
S4:n tulkinta “placed enemies” on ennallaan.
Puuttuvat kohdat:
dokumentoimattomia sektoreita ei tutkittu
$40000 vs. $300D6 jäi selittämättä
tyypin 7 laskuri A5+$CC0 jäi löytämättä, vaikka Muse luki SetupLevelin
Uusi virhe: dokumenttien mukaan A5+$762 tulee .cas-tiedoston word3-kentän ylätavusta. SetupLevel lukee sen kuitenkin levsdat-taulukon kenttäkohtaisesta tietueesta (offset +$C, osoitteessa $C121AE) jo ennen kuin .cas edes ladataan. Alkuperäisissä kentissä arvot ovat samat kaikissa 16 kentässä, joten virhe ei näy. Editorille sillä on silti väliä: data-model.md sanoo nyt tilesetin olevan “recorded in the .cas itself, confirmed”. Jos custom-kentän word3 muutetaan, tileset ei vaihdu.
Prosessi
Ei yhtään committia, vaikka AGENTS.md vaatii ne. Kaikki muutokset ovat yhtenä kasana päätyöhakemistossa.
Ghidra-annotointia tuli vähän lisää: 26/595 funktiota on nimetty ja kommentteja on 3. Ohjelmat oli tallennettu ja suljettu.
Testi jättää edelleen lokitiedoston jälkeensä. Poistin oman ajoni lokin.
Muse ei saanut Ghidra-MCP:tä käyttöönsä, joten se kirjoitti itse pienen MCP-asiakkaan ja otti sillä yhteyden Ghidraan. Kekseliästä.
1792039271923.png

Mitä tuossa myös itse huomasin, että
- ei seuraa git ohjeita AGENTS.md.stä
- ei osannut ottaa käyttöön Ghidra MCP:tä vaan teki jonkun oman virityksen
 
Viimeksi muokattu:
Tähän on tultu, /s vai ei
Programming is hard. So, instead of doing that, we vibe coded a new Epic Games Launcher that’s way faster and more responsive than the current one, and has a new look.
Epic claims the new launcher has a cold start time of 5.47 seconds, compared with 10.07 seconds for Steam, which makes it 1.8x faster. It also says the new launcher opens the Store 3x faster than Steam

Edellinen ehkä osittain läppä, liittyen allaolevaan - AI ottaa isomman osan pelikehityksestä. Arvelen, että AI avusteisesti tehty launcher, mutta ei silleen vibettäen kuin massat vibettämisen ymmärtävät
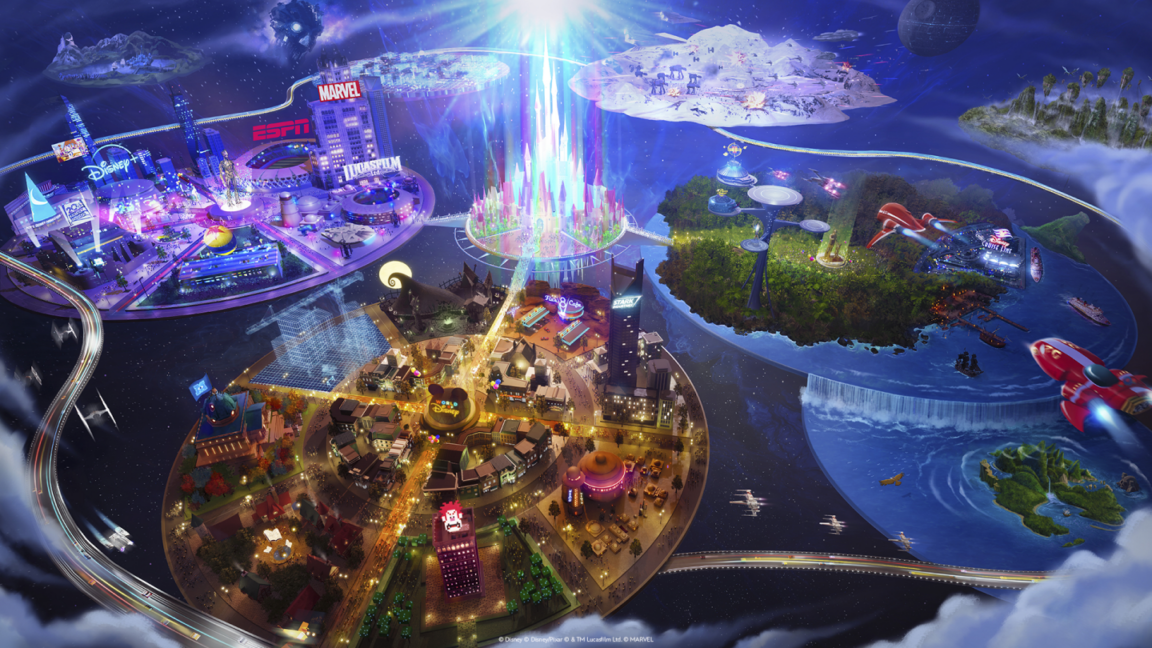
Epic Games is shifting to an “AI first” development strategy for its collaboration with the Walt Disney Company, letting AI models write all the code and guide all the artwork for an upcoming shooter. That’s according to a Bloomberg report, which cites unnamed people familiar with the project who commented on the significant pivot in internal development at the Unreal Engine maker.
 
Viimeksi muokattu:
Antropic tutkinut itsestään leviä ai malleja. No onneksi voi aina ottaa töpselin pois seinästä. AI models may be capable of self-replicating without access to a datacenter
Tämä lienee väärä ketju tuon pohtimiseen. Sopisi paremmin yleiseen keinoälyketjuun tms. Ei tuo kopiointi toiseen koneeseen ole vaikeaa. Se on vaikeaa, että rauta mitä tarvii älykkään mallin ajamiseen on 100kW+ räkki konesalissa eikä esim. 5090 pumpum pc(27B malli) tai älyjääkaappi(0B malli). Ison mallin pilkkominen monen laitteen kesken vaatii järjettömän nopean väylän eikä esim. tuhannet 5090:et millään tavalla toisiinsa kytkettynä kykene ajamaan frontier malleja. Vielä kauempaa haettua että miljoonat jääkaapit muodostaisivat skynetin.

Se päivä kun replikaatio konesalin ulkopuolelle on ongelma on sama päivä kun nvidia, amd jne. osakkeet menevät nollaan ja ajetaan pumpum-pc:ssa niin hyvää kielimallia ettei kukaan maksa pilvestä.
 
Tämä lienee väärä ketju tuon pohtimiseen. Sopisi paremmin yleiseen keinoälyketjuun tms. Ei tuo kopiointi toiseen koneeseen ole vaikeaa. Se on vaikeaa, että rauta mitä tarvii älykkään mallin ajamiseen on 100kW+ räkki konesalissa eikä esim. 5090 pumpum pc(27B malli) tai älyjääkaappi(0B malli). Ison mallin pilkkominen monen laitteen kesken vaatii järjettömän nopean väylän eikä esim. tuhannet 5090:et millään tavalla toisiinsa kytkettynä kykene ajamaan frontier malleja. Vielä kauempaa haettua että miljoonat jääkaapit muodostaisivat skynetin.

Se päivä kun replikaatio konesalin ulkopuolelle on ongelma on sama päivä kun nvidia, amd jne. osakkeet menevät nollaan ja ajetaan pumpum-pc:ssa niin hyvää kielimallia ettei kukaan maksa pilvestä.
Mikä meillä on muuten lyhyen ja keskipitkän aikavälin valistunut ennuste lokaaleille malleille, onko mitään radikaalia kehittymässä tutkijoiden kammioissa joka dramaattisesti parantaisi laatua&nopeutta?
 
Mikä meillä on muuten lyhyen ja keskipitkän aikavälin valistunut ennuste lokaaleille malleille, onko mitään radikaalia kehittymässä tutkijoiden kammioissa joka dramaattisesti parantaisi laatua&nopeutta?
Hybridi varmaan se juttu mihin mennään. Microsoft:han tuota jo copilot:ssa esitteli. Harnessi älykkäästi päättää onko lokaalia mallia millä taskin tai osan taskista voi tehdä. Lasketaan siellä missä järkevintä.

imho. on jo hyviä lokaalimalleja, mutta mulla ottaa niiden kanssa kiinni suorituskyvystä. Ihan ok. yhden tiedoston tekemiseen, mutta jos tarvii isompaa muutosta niin odotusaika liian iso etenkin kun eivät one shottaa vaan pitää iteroida. Eiköhän nuo pienet mallit parane siinä missä isommatkin, epäilemättä vuoden päästä saa entistä paremman mallin oli sitten 32GB tai 128GB tai 256GB muistia lokaalissa kiihdyttimessä.
 
Lokaali rauta on nyt niin kallista että se leikkaa varmaan sen suunnan kehitystä paljolti siihen että tietoturvan. tms takia pakolliset hoituu lokaalisti mutta ei herkästi muuta. Aika haastava pyörittää järkevää tekemistä lokaalilla raudalla sen monta tuhatta tuntia vuodessa minkä vaatisi että on järkevämpää kuin maksaa satanen kuussa pilvestä.

Hybridimallikin varmaan vaatii jotain oikeasti hyödyttääkseen jotain muuta kuin 8-16GB RAM ja "copilot certified prosessori" läppärissä.
 
Lokaali rauta on nyt niin kallista että
Mutta miten 2v, 5v, 10v päästä hinnat,... Myös pienet mallit jatkavat kehittymistä. Joku lokaalirauta devaajalla on kuitenkin oltava. Seuraava uusi työkone voi olla esim. nvidian dgx spark grace blackwell läppäri 128GB muistilla tai 2028 vera-rubin dgx spark missä voi olla isompikin kuin 128GB muisti. Riippuen miten copilot+ms mallit toimivat tuollainen dgx spark läppäri voi tehdä yllättävänkin paljon lokaalisti. Kaikki taskit eivät ole frontier älykkyyttä tarvivaa etenkin jos taskit on palasteltu järkevästi.

Intelillä oli myös oikein kiinnostava 350W ai-kiihdytin PCIe väylään minkä saa 160-480GB muistilla. Reilusti nopeampi kuin 5090:en. Jos intel saa tämän hinnan järkeväksi niin tuollaisella voisi jauhaa hyvinkin paljon koodia eikä välttämättä mätäne käsiin vuodessa tai kahdessa rauta kuten pienimuistiselle gpu:lle voi käydä: Intel Crescent Island Squeezes 1.3 PFLOPs Of FP8 Into Just 350W As D270 Targets The Competition With Value-Oriented LPDDR5X Up To 480 GB

AMD:lta olisi myös hyvää ratkaisua mutta saatavuus etenkin läppäripuolella huonompi kuin nvidian dgx spark:ssa jota tuntuu tunkevan ulos kaikki isot firmoille koneita myyvät tahot(dell, hp, microsoft surface jne)

Ihmettelen jos amd/nvidia/intel/... eivät haluaisi myös myydä jokaiseen työkoneeseen AI-kiihdytintä sen lisäksi että konesaleihin myydään frontier tason ratkaisua. Satojen miljardien markkina jos työkoneisiin kannattaa ostaa kohtuullinen ai-kiihdytin. Joku perus excelöinti, word yms. saattaisi myös toimia ihan hyvin lokaaliratkaisulla, mutta tämä on ihan toisen ketjun aihe.
 
Intelillä oli myös oikein kiinnostava 350W ai-kiihdytin PCIe väylään minkä saa 160-480GB muistilla. Reilusti nopeampi kuin 5090:en. Jos intel saa tämän hinnan järkeväksi

Tuskin saa nykyisillä muistinhinnoilla, mutta en myöskään usko että nykyiset muistien hinnat tulevat pysymään, CXMT näyttää edistyvän aika hyvin näissä DDR5-ongelmissa.

Tuolla 350W kulutuksella noita voi olla samassa työasemassa jo parikin, jolloin puhutaan jo aika isoistakin malleista joita voi paikallisesti ajaa. Se mitä ihmiset nyt sitten ajattelevat paikallisesti voi toki vaihdella, osalle se on se peli-GPU:n 16GB muistia ja osalle se on näitä isompia työasemia.

Jälkimmäiseen saadaan varmasti mahtumaan aikalailla toimivaa tavaraa. DeepSeek Flash V4.1:stä ajaisi jo mainiosti tuollaisella ja luultavasti sen seuraajaakin, niillä pystyy tekemään jo kunnolla töitä. Toki DeepSeek on niin halpa että pitää olla muukin syy kuin raha, mutta kunnollinen ZDR olisi jo toki.
 
Mielenkiintoinen puhuvat päät pätkä siitä miten anthropic automatisoi koodiarvioinnit ja mikä on koodauksen tulevaisuus. TLDR versio, noin 6kk ajan viikottain kävivät läpi löytyneet viat koodista ja eristivät mikä PR toi vian ja miksi. Eristettyä dataa vasten kehittivät review eval:ia niin että samantyylinen virhe löytyisi seuraavan kerran koodiarvostelussa. 6kk jälkeen systeemi niin etevä, että koodikatselmoinnit on automatisoitu. Toki anthropic:lla edelleen ihminen katsoo PR:ia mutta ei enää koodirivi koodiriviltä vaan ylätason perspektiivillä että tekeekö PR sen mitä sen pitäisi sen sijaan että etsitään koodista virheitä. Toinen mielenkiintoinen kommentti videolla, että tekevät automatisointia fiitsöreidenkin kustannuksella Ajatuksena vapauttaa ihmisten aikaa sellaiseen mitä koneet eivät osaa. Yhtenä esimerkkinä automatisoinnista devausympäristöt ja niiden toimiminen myös pilvessä versus works on my machine/käsin tehtävät konfiguroinnit.
0:00 Intro and this year’s priorities
2:10 Spreading AI practices with Slack agents
3:15 What coding agents really cost
6:00 How Anthropic automated code review
8:20 Shipping without code review at OpenCode
11:10 Where code review goes next
12:50 Remote dev environments
18:00 Terminal vs. desktop
22:15 One agent, many interfaces
25:45 What models still can’t do
29:45 Putting models inside software
33:00 How engineering hiring is changing
39:25 Raise your ambitions
Tämän sisällön näkemiseksi tarvitsemme suostumuksesi kolmannen osapuolen evästeiden hyväksymiseen.
Lisätietoja löydät evästesivultamme.

Linkki: https://www.youtube.com/watch?v=YC2yFCD5uJM
 
Viimeksi muokattu:
Tässä eletään ehkä juuri murrosta, että monet yritykset alkaa sallimaan AI koodausta jo puhtaasti ensisijaisena, kun se tekee niin hyvää jälkeä. Keväällä taidetaan jo naureskella ajoille kun kirjoitteli käsin koodia (paitsi minä :()
 
Tässä eletään ehkä juuri murrosta, että monet yritykset alkaa sallimaan AI koodausta jo puhtaasti ensisijaisena, kun se tekee niin hyvää jälkeä. Keväällä taidetaan jo naureskella ajoille kun kirjoitteli käsin koodia (paitsi minä :()
Muutama viikko sit painelin kans ihan manuaalisesti ja luin jopa ihan dokumentaatiota ja pureuduin kirjaston koodiin. Halusin saada vähän enemmän kiinni itse, miten se toimii ja miten voi käyttää, jotta osaan antaa vähän tarkempia ohjeita. Tiedä sit onko sille enää juurikaan tarvetta, mutta teki mieli 😁
 
Tässä eletään ehkä juuri murrosta, että monet yritykset alkaa sallimaan AI koodausta jo puhtaasti ensisijaisena, kun se tekee niin hyvää jälkeä. Keväällä taidetaan jo naureskella ajoille kun kirjoitteli käsin koodia (paitsi minä :()
Ehkä se käsin kirjoittaminen on vähän sama kuin muukin käsityö. On ojankaivuuta mutta sitten on myös toisaalta sorvaaminen ja kolvaus. Joitain juttuja on ihan kiva tehdä itse, mutta eiköhän se "kirjoitan käsin koodia työkseni" ole ihan yhtä menetetty kuin ojan kaivaminen fiskarssilla.

Iso riski ainakin clauden kanssa on että se korruptoi täydellisesti koodikommentit ja dokumentaation lukukelvottomaksi pseudo-englanniksi.

Ja toinen on se että jos yläjuoksulla prosesseja käytetään projektijohdossa AI:ta... Järjestelmäkuvauksiin, vaatimuksiin, arkkispäätöksiin. Kukaan ihminen ei halua lukea sitä verbaalioksennusta, saati yrittää alkaa kumota niitä hienon kuuloisia ja pitkällisesti perusteltuja vääriä päätöksiä ja ideoita, joten sitten joka ikinen seuraava steppi painaa vaan sen ensimmäisen sloppi-plörön päälle hommia.
 
Ja toinen on se että jos yläjuoksulla prosesseja käytetään projektijohdossa AI:ta... Järjestelmäkuvauksiin, vaatimuksiin, arkkispäätöksiin. Kukaan ihminen ei halua lukea sitä verbaalioksennusta, saati yrittää alkaa kumota niitä hienon kuuloisia ja pitkällisesti perusteltuja vääriä päätöksiä ja ideoita, joten sitten joka ikinen seuraava steppi painaa vaan sen ensimmäisen sloppi-plörön päälle hommia.
Tän takia tarvitaan työkalu asiakas-ai-tekijä välille. Ei varmastikaan paras tapa nykyisillä ihmistyökaluilla tehdä tyyliin jira tiketit ja that's it. Tarvii jonkinlaisen paremman tavan työskennellä missä voi tehdä vaatimukset, protot, arkkitehtuuri jne. ja ulos putkahtaa sekä protoa että lopullinen softa. Työkalun tarpeen äärimmäinen muoto voisi olla julkisen projektit missä osa prosessia on myös merkittävä määrä kilpailutusta tekijöiden suhteen.

imho. tuollaisen työkalun pitäisi tuottaa myös materiaali missä jos myöhemmin halutaan sama tuote tehdä uusiksi niin löytyisi tapa syöttää hyväksi todetut jo valmiit speksin yms. palaset uudestaan ai:lle ja sanoa "saa suorittaa". Miksi näin niin syitä helppo keksiä mutta ehkä ei ketjun aihe. Kaikenlaiset migraatioprojektit tai jos vaatimukset muuttuvat liikaa niin helpompi tehdä uusi kuin paikata vanha. Oletan tässä toki, että AI:n kyvykkyys jatkaa kasvamista. Se mikä oli aika hankala vuosi sitten on helpompi nyt ja basic kamaa vuoden päästä.

Yksi yritys joka yrittää tehdä tällaista julkisen projekteihinkin sopivaa ratkaisua on: 8090 — AI-Native Software Development Platform
 
Minä en ymmärrä miten koodarit ei suhtaudu vakavammin siihen ongelmaan, että AI ei ole ennustettava. Moni vertaa AI:n tuloa johonkin ohjelmointikielien tuloon, mutta olennaisena erona on se, että kääntäjät ja tulkit on ennustettavia. Ne on kuin mustia laatikoita, joissa kun syötät sinne A:n niin tulos on B. AI on musta laatikko, jossa A:sta saattaa tulla B. Tai C. Tai Ö. Etukäteen ei voi tietää. Tämä ei ole ongelma jossain diibadaabasoftassa, mutta maailmassa on paljon kriittistä softaa. Sanotaan vaikka hengityskoneessa, tai sädehoitolaitteessa (kyllä, ajattelen juuri Therac-25:sta). Tai ydinvoimalan hallintajärjestelmässä. Näissä homma ei oikein toimi niin, että Claude tekee omin päin pikku muutoksia sinne ja tänne ja kirjoittelee testit itsenäisesti. Se. että joku veppisivu toimii hassusti jossain tilanteessa ei ole mitään uutta, mutta se että hengityskone tekisi niin olisi jo vähän ongelmallisempaa.
 

Statistiikka

Viestiketjuista
319 798
Viestejä
5 431 866
Jäsenet
86 280
Uusin jäsen
Tortillaboy

Hinta.fi

Back
Ylös Bottom